Un anno fa, il primo articolo di questo blog diceva che due progetti open source “stanno rivoluzionando l’architettura dei data lakehouse moderni”. Quella frase l’ho scritta io, e ci credevo.
Dodici mesi e 24 articoli dopo, i miei titoli suonano diversi. “La velocità è la parte noiosa.” “Esattamente gli stessi watt.” “La parte utile è quando dice di no.” A un certo punto ho smesso di annunciare cosa potevano fare gli strumenti e ho cominciato a controllare cosa facevano davvero. Compresi quelli che avevo costruito io, che si sono rivelati i più bisognosi di controlli.
Ho aperto il blog per colmare un vuoto. Rust, un linguaggio di programmazione noto per essere veloce e difficile da usare male, compariva in sempre più strumenti per i dati. Quando cercavo qualcosa da leggere sull’argomento, trovavo note di rilascio, talk sparsi e qualche benchmark. Quasi niente spiegava cosa facessero quei progetti, come si incastrassero tra loro, o se valesse già la pena usarli. Così ho scritto gli articoli che avrei voluto trovare.
Questo è lo sguardo indietro: cosa ha retto, cosa no, e cosa sto cambiando. È scritto per chi non ha mai sentito nominare nessuno degli strumenti di cui parlo. Se sei tu, bene. Sei il lettore che quest’anno non sono riuscito a raggiungere.
Le tubature che nessuno nota
Quasi tutto quello di cui scrivo è infrastruttura dati: il software che raccoglie i dati, li conserva, li sposta e controlla che ci si possa fidare. Sta dietro ogni dashboard e ogni modello di machine learning. Quando funziona, nessuno se ne accorge. Quando si rompe in silenzio, qualcuno prende una decisione basata su numeri sbagliati.
Gli articoli si dividono in tre gruppi.
Strumenti costruiti da altri. RisingWave elabora i dati nel momento in cui arrivano. Lakekeeper tiene un registro di dove si trova ogni tabella e di chi può usarla. Polars analizza quelle tabelle. Lance è un modo di conservare i dati pensato per il lavoro con l’AI. Mosaico è una piattaforma dati per i robot. E dbt è quello che migliaia di team usano per trasformare i propri dati con SQL.
Strumenti che costruisco io. dataprof ispeziona un dataset e segnala cosa c’è che non va. Ceres è un motore di ricerca per gli open data pubblici, perché le pubbliche amministrazioni raramente chiamano i loro dataset come li cercherebbero le persone. Nephtys è un piccolo programma che sposta dati tra dispositivi.
Esperimenti sfuggiti di mano. Un weekend passato a pulire una PS5 è finito con un Raspberry Pi che gestisce la mia rete di casa, le mie password e i miei backup, e con un piccolo progetto chiamato Lares. Ho provato a far stare idee da pipeline di dati su un microcontrollore con 520 KB di memoria, meno di una sola foto sul telefono. E ho costruito un modello per l’asta del fantacalcio. La sua funzione più utile era dirmi quando smettere di rilanciare.
Cosa ha retto
Puoi aprire il codice e sistemarlo. È il motivo per cui ho iniziato, ed è ancora la parte migliore. Quando uno strumento open source si comporta male, puoi leggerne il codice, trovare la riga e proporre una modifica. Nei primi quattro mesi una quarantina di queste modifiche sono state accettate nei progetti di altri: Polars, Apache Iceberg, Lance, Tokio (la libreria su cui gira gran parte del software di rete scritto in Rust), e una decina in Mosaico. Molte erano piccole. Un refuso, un messaggio di errore più chiaro, un po’ di pulizia. Sono state il mio modo di imparare a orientarmi.
Poi i contributi sono diminuiti, e ognuno è nato da qualcosa che si rompeva mentre lo usavo per il mio lavoro. Due sono finiti in Apache Arrow, un formato comune per tenere i dati in memoria che permette a un programma di passare una tabella a un altro senza doverla prima convertire. Entrambe le correzioni erano proprio nel codice che gestisce quel passaggio. Contano per me più di quelle iniziali. Qualcun altro avrebbe incontrato quei bug, probabilmente nel momento peggiore.
Rust ha vinto, senza farsi vedere. Un anno fa scommettevo che Rust sarebbe diventato una base seria per il software dei dati. La prova più forte è arrivata ad agosto, quando ho aperto il codice di dbt per segnalare un bug e ho trovato 77 pacchetti Rust dove prima c’era il motore Python. Uno degli strumenti per i dati più usati al mondo aveva riscritto il proprio motore senza far rumore.
Ed è qui che i miei primi articoli avevano sbagliato. I primi tre descrivevano un insieme di strumenti Rust che, messi insieme, avrebbero potuto sostituire il software Java su cui girano quasi tutte le grandi piattaforme dati. Non è mai successo. Rust si è diffuso entrando dentro gli strumenti che le persone usano già. Chi usa dbt scrive ancora SQL. Chi usa Polars e Lance scrive ancora Python. Quello che notano è una nuova versione più veloce e che coglie più errori. Probabilmente è un risultato migliore di quello che avevo previsto. Avevo solo sbagliato il disegno.
L’articolo su Lakekeeper. Tra i primi, è quello invecchiato meglio. Uso ancora Lakekeeper, e due delle mie correzioni di quest’anno sono finite lì. Gli articoli invecchiati peggio sono quelli scritti con l’entusiasmo del nuovo arrivato, dopo poche settimane dentro un progetto e prima di averlo usato per qualcosa di mio.
Cosa non ha retto
Quest’anno sono cadute tre convinzioni. La terza l’ho ripetuta più di una volta.
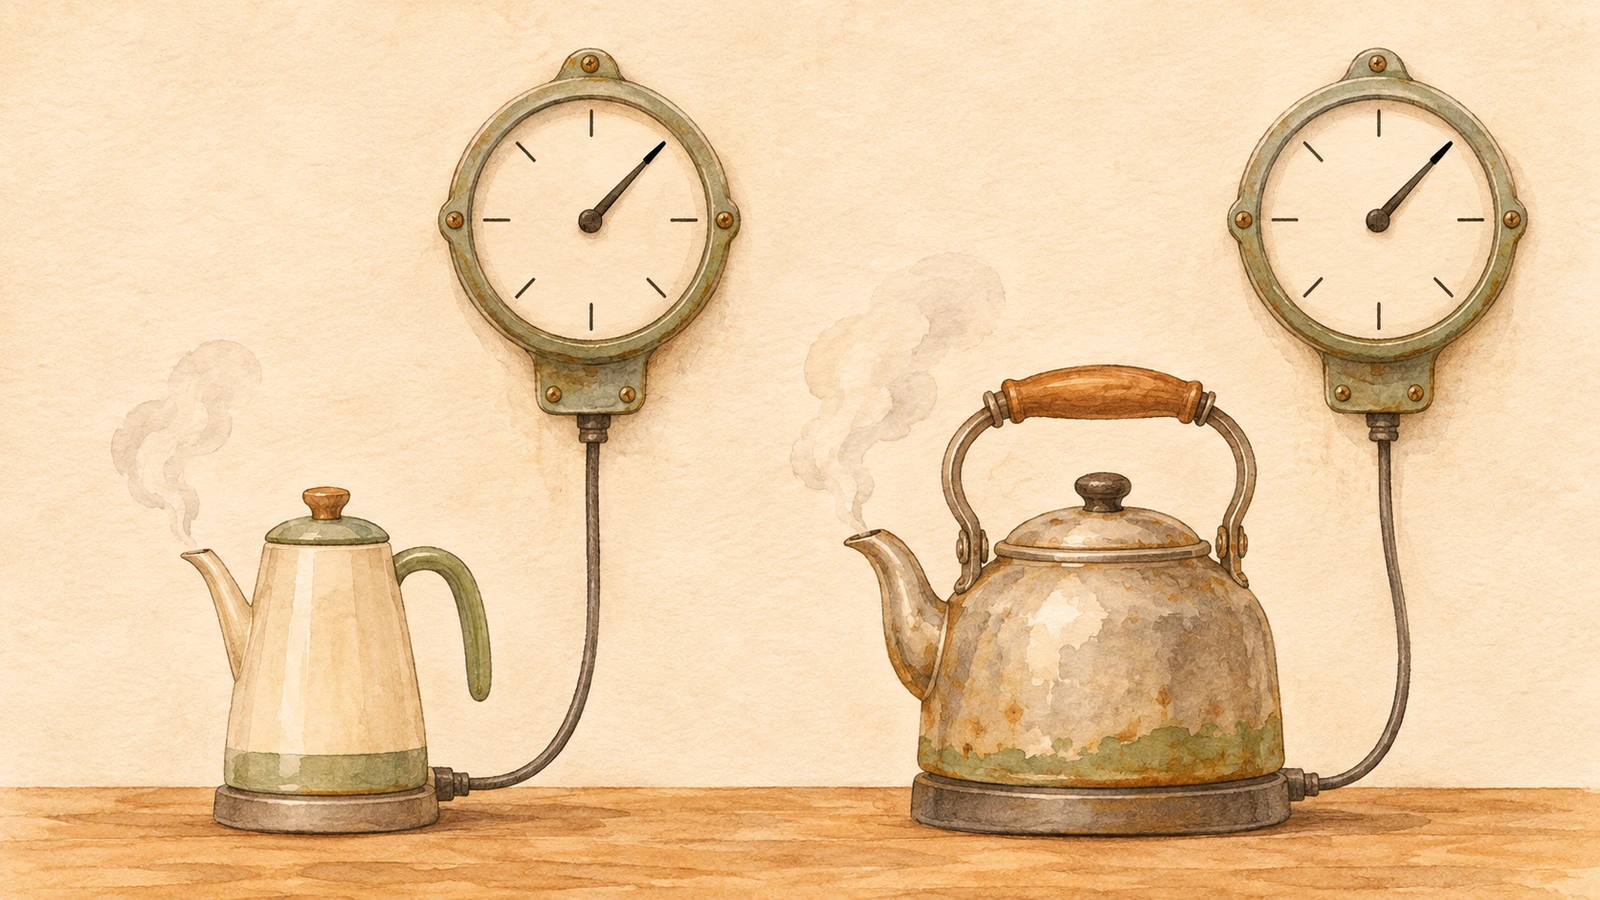
“Meno memoria vuol dire meno elettricità.” A luglio ho misurato Nephtys su un Raspberry Pi 5 contro Node-RED, uno strumento molto diffuso per lo stesso compito. Il mio usava 6,6 volte meno memoria. E assorbiva esattamente la stessa potenza. Davo quasi per scontato che un programma più leggero costasse meno da far girare. Su quel piccolo computer, alla bolletta non importava. Misura la cosa che paghi, separatamente da quella che fa bella figura in un grafico.
“Se due strumenti condividono un formato, si comportano allo stesso modo.” Apache Iceberg e Delta sono due insiemi di regole per conservare tabelle come normali file, così che programmi diversi possano leggere e scrivere gli stessi dati. A settembre ho provato ad aggiungere un controllo di qualità che doveva passare prima che i nuovi dati venissero salvati in modo definitivo. Con Delta ha funzionato. Anche le regole di Iceberg lo permettevano, ma la libreria Rust che usavo teneva quell’opzione per uso interno, quindi un programma esterno non poteva far aspettare il salvataggio fino all’esito del controllo. Due strumenti possono leggere gli stessi file e trovarsi comunque in disaccordo proprio nel momento che conta. Ho pubblicato un piccolo esempio che riproduce il problema e l’ho segnalato al progetto.
“Verde vuol dire che funziona.” Il mio verificatore di backup segnava 24 controlli superati su 24 mentre il job di backup era fallito. Controllava che un backup fosse pianificato e che esistesse una copia recente. Non si chiedeva mai se il backup della notte prima fosse andato davvero. L’esperimento su Iceberg aveva la sua versione. Un test pensato per cogliere due programmi che salvano nello stesso istante passava ogni volta. In 40 round, i due programmi non si erano mai davvero sovrapposti. Quando li ho costretti a farlo, il test ha trovato un duplicato. Ho raccolto questi casi in un articolo su cosa dimostra davvero una luce verde. Se di quest’anno leggi un solo articolo, leggi quello.
Come è cambiato il lavoro
A marzo ho risposto a un’intervista su un anno di lavoro con Claude Code, un assistente AI per scrivere codice. Ho detto che scrivevo a mano meno del 10% del mio codice. È ancora vero.
Ha cambiato il mio mestiere. Quando quasi tutto il codice viene scritto per te, la parte difficile diventa decidere cosa conta come prova che funziona. Un test che passa, una dashboard verde e un riassunto sicuro di sé sembrano tutti uguali finché non chiedi cosa hanno controllato davvero. Gli articoli di quest’anno di cui vado più fiero parlano tutti di questa domanda, e probabilmente non è un caso. La stessa regola vale qui: un assistente AI mi aiuta a scrivere le bozze, e ogni affermazione deve sopravvivere al confronto con il codice.
Anche dataprof è cambiato. È nato come progetto mio. Quest’anno 21 altre persone hanno contribuito al suo codice, e This Week in Rust, la newsletter settimanale della comunità, lo ha segnalato come un buon posto dove i nuovi arrivati possono scegliere un primo compito.
A ottobre l’ho finalmente usato come lo userebbe uno sconosciuto: come un pezzo dentro una piccola pipeline di dati, una catena di passaggi che carica i dati e decide se sono pronti per l’uso. Mi ha messo in imbarazzo due volte. dataprof considera vecchie le date che superano un certo numero di anni, contati da oggi. Il 1° gennaio cambia il calendario, le date di giugno 2021 in un file che nessuno ha toccato superano quella soglia, e il punteggio scende da 81 a 69. Stesso file, verdetto diverso, a seconda del giorno in cui lo chiedi. E approvava tranquillamente dieci righe di dati quando la pipeline se ne aspettava diecimila. La seconda lacuna è stata corretta in meno di una settimana. La prima mi ha insegnato sulla mia libreria più di un anno passato a scriverla.
Quattro scommesse per l’anno prossimo
Le verificherò il prossimo novembre.
Rust continuerà a diffondersi, e la maggior parte delle persone non lo vedrà mai. Lo incontrerai come “la nuova versione è più veloce”, dentro strumenti che usi già, nei linguaggi che scrivi già.
Il registro delle tabelle diventerà il posto che decide chi può fare cosa. Strumenti come Lakekeeper, o Unity Catalog dentro la piattaforma Databricks, sono nati come elenchi di dove si trovano le tabelle. Sempre più spesso decidono chi può leggerle e modificarle. Entrambe le mie correzioni a Lakekeeper di quest’anno servivano a far sì che un cambio di permessi venga registrato prima di avere effetto. Dettagli come questo conteranno sempre di più, man mano che questi registri diventano i guardiani dei dati.
Mettersi d’accordo sui formati era la parte facile. Il lavoro difficile che ci aspetta è mettersi d’accordo sui comportamenti: cosa succede quando due programmi salvano nello stesso momento, o quando uno si ferma a metà. È meno visibile di un nuovo formato, ed è da lì che sono venuti quasi tutti i problemi veri che ho incontrato quest’anno.
Più codice scrive l’AI, più contano i controlli. Un controllo che passa per il motivo sbagliato è sempre stato un problema. Quando chi legge il risultato non ha scritto il codice, il problema diventa molto più grande. È la scommessa a cui tengo di più, e quella su cui continuerò a scrivere.
Ho raggiunto pochi lettori, e la causa ero io
I miei numeri su LinkedIn calano da mesi. L’ultimo post che ci ho condiviso aveva zero reazioni quando ho controllato. La tentazione di dare la colpa all’algoritmo è forte. Poi ho riletto i miei articoli.
Uno dei miei titoli di quest’anno conteneva pub(crate), un pezzo di codice Rust che significa più
o meno “solo per uso interno”. Solo uno sviluppatore Rust può leggere quel titolo, e la maggior
parte di loro ci passerebbe sopra. I post su LinkedIn che presentavano gli articoli spesso erano
peggio. Descrivevano il lavoro e rimandavano la scoperta a dopo, e in un feed social dopo vuol dire
mai.
I riscontri utili sono arrivati per altre strade. Un peer reviewer mi ha chiesto se Nephtys girasse davvero su hardware piccolo, ed è così che ho finito per misurarlo su un Raspberry Pi. Il maintainer di una raccolta curata di strumenti per Polars mi ha chiesto se dataprof potesse avere un pacchetto R, e ne è nata una risposta pubblica su cosa servirebbe e perché deve aspettare. Ognuna di quelle conversazioni ha cambiato quello che ho fatto. Nessun conteggio di reazioni l’ha mai fatto.
Ho scritto per chi conosceva già gli strumenti, sperando che tutti gli altri mi seguissero. L’anno prossimo cambio direzione:
- ogni articolo comincia spiegando perché il problema conta, con parole che non richiedono conoscenze precedenti;
- il gergo viene spiegato la prima volta che compare, oppure tagliato;
- ogni articolo finisce con una risposta semplice: cosa ha funzionato, cosa no, e cosa farei al tuo posto;
- i dettagli tecnici più profondi si spostano nei repository del codice, dove puoi eseguirli;
- le idee piccole diventano articoli brevi;
- quando condivido un articolo, la prima riga dice cosa ho scoperto.
Il lavoro resta lo stesso. Deve ancora essere testato, misurato e onesto su cosa non ha funzionato. La spiegazione deve diventare abbastanza buona da farti capire se ti riguarda, senza dover spendere le ore che ho speso io per scoprirlo.
Prossimo passo
Il primo progetto del nuovo anno riprende la pipeline di ottobre: decidere se i dati appena arrivati sono pronti per l’uso, e cosa fare quando non lo sono. Lo racconterò nel nuovo stile, e mi dirai tu se ha funzionato.
Se quest’anno hai letto uno di questi articoli e ti sei perso a metà di un paragrafo, la colpa è mia. Mi piacerebbe davvero sapere quale. Grazie per aver letto.