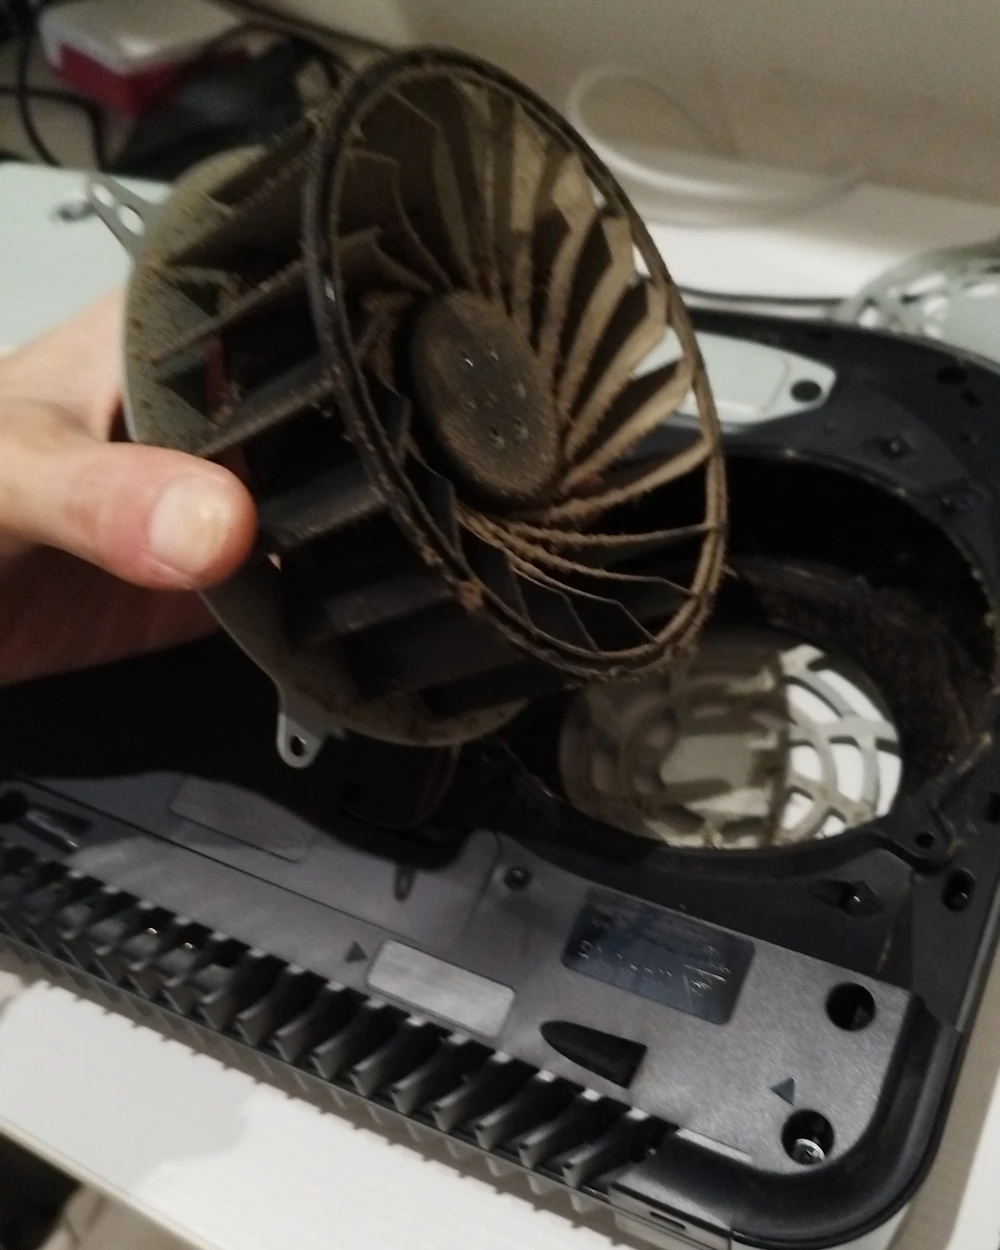
Lo scorso weekend è iniziato con me che toglievo la polvere dalla PS5.
Niente di drammatico. Pannelli laterali via, ventola fuori, aspirapolvere a portata di mano. Uno di quei lavori che rimandi per mesi perché la console tanto funziona, finché un sabato la guardi e decidi che, a quanto pare, oggi è il giorno.
Qualche ora dopo stavo configurando un DNS su un Raspberry Pi.
Domenica sera avevo un password manager, dei backup offsite, una procedura di disaster recovery e un progetto open source nuovo di zecca. Niente di tutto questo era previsto.
Un Pi senza niente da fare
Il Pi era già lì. L’avevo comprato quest’anno per Nephtys, perché volevo hardware edge vero per i benchmark invece di fidarmi dell’opinione del mio portatile su cosa conti come “edge”. I benchmark erano finiti. Quello che restava era un Pi 5, un Samsung T7 e la sensazione che la macchina dovesse fare qualcosa nel restante 99% della sua vita.
Non volevo l’ennesimo deploy giocattolo. Volevo una macchina di cui mi sarei accorto se fosse andata offline.
Tanto per chiarire la scala: questo non è un homelab. È un Pi con 4 GB di RAM, lo swap su zram (quindi “basta aggiungere swap” vuol dire spendere RAM per risparmiare RAM) e un solo SSD, che è anche il disco di boot. Niente NAS, niente cluster, nessun nodo di riserva. Sinceramente, ha semplificato le cose.
Tutto è finito in un repository privato. Lo chiamerò il repo di casa, visto che tanto non potete aprirlo: descrive la mia macchina reale, con il suo hostname, lo storage, la mia rete e tutti i piccoli compromessi che un computer vero si porta dietro.
Poi ho iniziato ad aggiungere le cose che mi vedevo davvero usare.
Syncthing, così il telefono manda le foto al Pi senza che ci debba pensare. Samba, perché un file
server dovrebbe comportarsi da file server e non richiedere scp ogni volta. Tailscale, che ha
reso noioso l’accesso remoto, ed è il complimento più bello che si possa fare all’accesso remoto.
Poi AdGuard Home. Poi Vaultwarden. Poi Uptime Kuma.
Come elenco, niente di interessante. Le cose si sono fatte interessanti quando ho iniziato a fidarmi.
Il vault ha rovinato l’atmosfera
Con un container per hobby puoi stare rilassato. La dashboard muore, la riavvii. Un password manager è un’altra storia: nel momento in cui Vaultwarden è finito sulla macchina, ho dovuto chiedermi cosa significasse davvero il mio backup.
A quel punto il backup era restic, che ogni notte spingeva il filesystem su Backblaze B2. Normalissimo. Solo che copiava anche un database SQLite vivo in modalità WAL, nel mezzo di qualunque transazione stesse girando in quel momento. Roba che funziona benissimo fino alla prima volta in cui conta.
Così adesso è SQLite stesso a farsi lo snapshot, con i lock giusti. Lo snapshot passa un
integrity_check, e solo dopo restic ha il permesso di vederlo. Se lo snapshot del vault fallisce,
fallisce tutto il backup.
Quest’ultima parte mi è costata due tentativi. La prima versione teneva su disco lo snapshot buono precedente quando quello nuovo falliva, il che sembra prudente finché non ti accorgi di cosa significa: il backup di oggi si porta dietro in silenzio il vault di ieri e dice comunque “successo”. Preferisco il rumore.
Il kernel aveva altri piani
Con la memoria è andata allo stesso modo. Con 4 GB da dividere, ho dato un limite di memoria a ogni container, e il file Compose era bellissimo.
Peccato che Raspberry Pi OS parta con il memory cgroup disabilitato, quindi Docker li aveva buttati
via tutti in silenzio. Una riga di warning, e docker inspect che riportava Memory=0 mentre il
file Compose sosteneva il contrario. La configurazione diceva che i container erano limitati. Il
kernel non era d’accordo, e queste discussioni le vince il kernel.
Mi piace questo esempio perché è tutto il weekend in miniatura. Verifichiamo di aver chiesto a un
sistema di fare qualcosa, e poi lo trattiamo come prova che l’abbia fatto. Così il repo di casa
si è riempito di controlli su ciò che è vero davvero: non “Compose contiene mem_limit?” ma “cosa
dice memory.max?”; non “il container DNS è su?” ma “un dominio bloccato torna bloccato?”.
Syncthing ha fatto lo stesso discorso in piccolo. Ha accettato un percorso che per me aveva perfettamente senso e ha scritto tutto, in silenzio, in un volume Docker anonimo, dove né Samba né il backup potevano vederlo.
Verificare il comportamento, non le dichiarazioni. È diventata la regola per il resto del weekend.
Domenica: fingere che il Pi sia morto
Domenica il Pi era diventato utile, il che ha creato un problema nuovo. Cosa succede quando muore l’SSD?
Se questa cosa tiene i miei file, il mio DNS e le mie password, “probabilmente mi ricordo come l’ho configurato” non è un piano. Così ho passato la domenica a fingere che la macchina fosse già morta.
Ne è uscito più codice che da tutti i servizi messi insieme: uno script di bootstrap che porta un Pi vuoto a un host funzionante, uno script di restore, timer systemd e immagini fissate per digest, perché scoprire a metà di un recovery che una nuova immagine di Vaultwarden ha deciso di migrarti il vault è un tipo molto particolare di brutta giornata.
Testare il restore è stato, ovviamente, il momento in cui ho rotto qualcosa. Ho puntato un restore
di prova su /tmp, che su Raspberry Pi OS è un tmpfs da 2 GB. In altre parole, RAM. La memoria
libera è scesa da 3,3 GiB a meno di 1 GiB prima che lo fermassi, sulla macchina che faceva da DNS a
tutti i miei dispositivi. Lo script di restore ora rifiuta le destinazioni tmpfs e controlla lo
spazio libero prima di partire.
Il monitoraggio ha avuto la sua versione della stessa storia. Uptime Kuma mandava gli avvisi a ntfy
allo stesso indirizzo HTTPS della tailnet che usa il mio telefono, cosa perfettamente ragionevole
finché non ti ricordi che l’avviso va da un container all’altro, e i container non risolvono i nomi
della tailnet. Quando ho fermato Vaultwarden per provarlo, il telefono è rimasto muto per tre minuti.
L’URL giusto era semplicemente http://ntfy.
Alla fine il recovery si è ridotto a tre cose che non devono morire insieme alla macchina: il repository, il backup cifrato offsite e le credenziali per aprirlo.
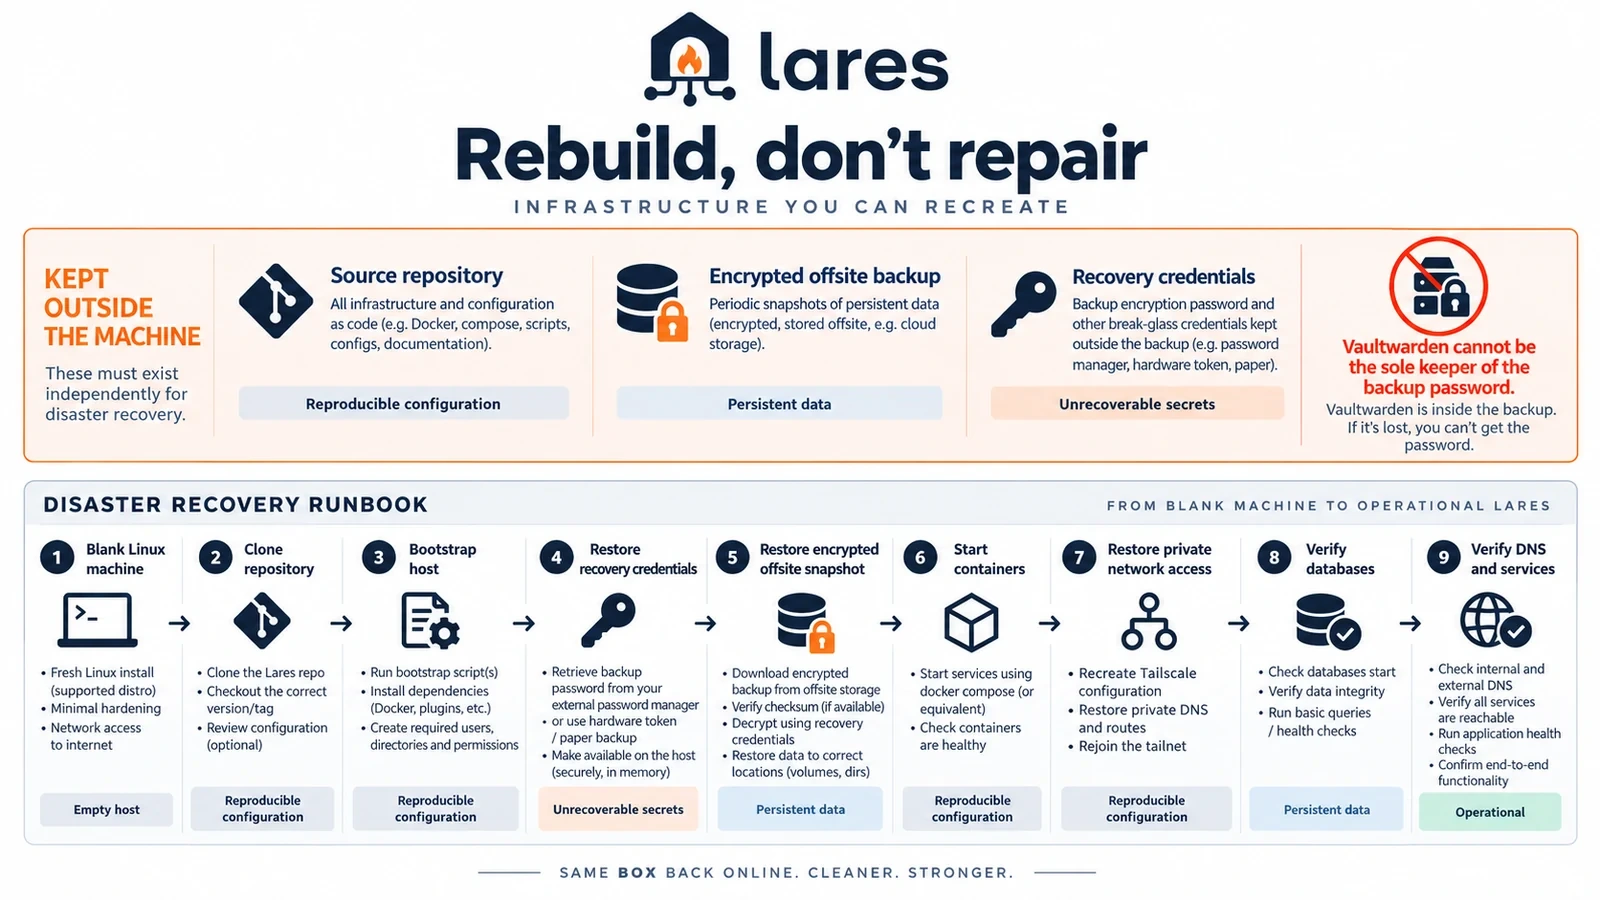
La terza nasconde una trappola deliziosa. Vaultwarden non può essere l’unico posto in cui sta la password del backup che contiene Vaultwarden. Servirebbe la password per ripristinare il vault che contiene la password. Ci ho messo più di quanto vorrei ammettere ad accorgermene. Il README del repo di casa, scritto sabato, dice in grassetto che la password di restic va in Vaultwarden.
Certi segreti devono vivere in un posto molto noioso. La carta, fastidiosamente, è ancora bravissima in questo.
Domenica sera: un progetto open source per sbaglio
Domenica pomeriggio ho guardato il repo di casa e ho capito che una parte poteva essere utile anche fuori da casa mia. Non l’elenco dei servizi: esistono migliaia di file Compose con dentro AdGuard e Vaultwarden. Le parti utili erano gli snapshot SQLite, i limiti di memoria verificati sul kernel, la protezione contro il tmpfs, le UI di amministrazione che non toccano mai la LAN e una procedura di recovery che avevo percorso davvero.
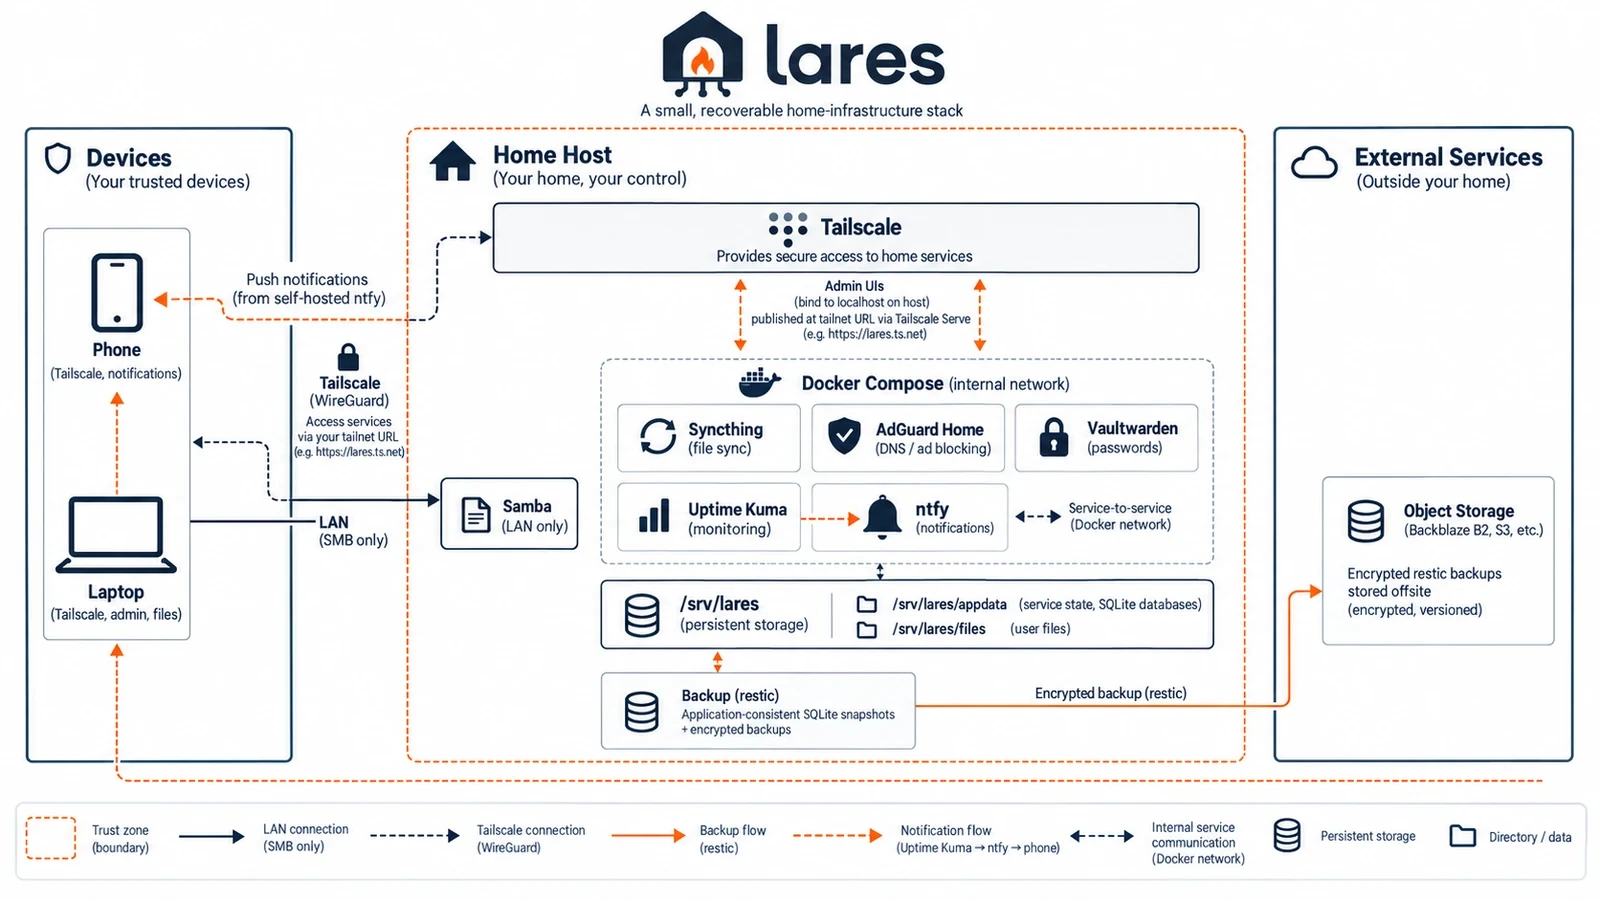
Il repo di casa sa troppe cose del mio Pi per diventare pubblico, ed è esattamente il suo lavoro. Così ho tirato fuori le parti che non erano specifiche di casa mia, e sono diventate Lares. Il nome viene dai Lari romani, le divinità protettrici della casa. Un po’ pretenzioso per un repo fatto soprattutto di snapshot SQLite e configurazione di Samba, ma mi piaceva.
La prima versione sembrava sorprendentemente pulita. Poi l’ho letta come se un estraneo stesse per clonarla, e ha cominciato a confessare.
Lo script di backup usava una variabile che esisteva solo sulla mia macchina, quindi ogni backup
programmato sarebbe morto prima di scrivere un byte. La configurazione di Samba conteneva
${PI_USER}, che Samba non espande. Il vero hostname del mio Pi era sopravvissuto alla pulizia in
compose.yaml. E un controllo di CI pensato per trovare variabili non definite lanciava gli script
con un ambiente vuoto, li guardava uscire per il file di configurazione mancante e diventava verde:
un test che passa su codice che non ha mai raggiunto. Ho già
scritto di questa esatta specie di bug, e a
quanto pare avevo bisogno di ripassarla.
E il mio preferito: il controllo che avevo scritto per evitare che l’ID della mia tailnet finisse online funzionava cercando l’ID della mia tailnet. Il rilevatore di leak era l’ultimo leak rimasto. Adesso cerca la forma di un leak invece di un elenco dei miei valori privati.
Renderlo generico ha costretto ogni assunzione a rispondere a una domanda: fa parte del design, o è solo vero a casa mia?
Lunedì: ha morso
Mentre sistemavo Lares domenica sera, ho trovato un bug nello script di backup. Prima di ogni esecuzione controllava se il repository restic esistesse, e se il controllo falliva dava per scontato che il repository non ci fosse ancora e ne creava uno.
Il problema è che “il repository non esiste” e “in questo momento non riesco a raggiungere il repository” da quel controllo sembrano identici. Indovina male e ti ritrovi un repository nuovo e vuoto che fa backup felice per sempre, mentre quello vero resta irraggiungibile e il monitor rimane verde. Così Lares ha smesso di tirare a indovinare. Fallisce, e dice cosa si rifiuta di decidere.
L’ho corretto in Lares. Nel repo di casa, quella sera, no.
Lunedì è scattato davvero. Un restore di prova che avevo interrotto con pkill aveva lasciato tre
lock nel repository su B2, il lock faceva fallire il controllo, e l’esecuzione notturna ha annunciato
che il repository non era inizializzato e ha provato a crearne uno nuovo. Esattamente sopra il backup
esistente.
Restic si è rifiutato, perché il repository era chiaramente già lì. Quel rifiuto è l’unica ragione per cui questa storia fa ridere.
E non è finita. Ho lanciato verify.sh, lo script che avevo scritto la sera prima proprio per
questo genere di cose, sul Pi rotto. Tutti e ventiquattro i controlli sono passati. Il timer era
attivo, uno snapshot recente esisteva, e intanto il job di backup era fermo in failed. Il mio
stesso verificatore controllava cosa era programmato, non cosa era girato davvero. Verificare il
comportamento, non le dichiarazioni. Sì, lo so.
Adesso entrambi i repo ripuliscono prima i lock vecchi, non creano mai un repository di loro iniziativa e controllano l’esito dell’ultima esecuzione. Se due guasti sembrano identici dal punto in cui ti trovi, l’automazione non ha il diritto di scegliere quello comodo.
Lunedì ha risposto anche a cosa succede se il Pi viene compromesso. La documentazione sosteneva che
una chiave B2 limitata a un bucket non potesse cancellare i propri backup; B2 diceva che la chiave
aveva deleteFiles. Adesso il Pi ha una chiave append-only: può aggiungere backup, non
cancellarli. Un’altra dichiarazione, un altro controllo.
Com’è andata a finire
Oggi i due repo si dividono il lavoro in modo pulito. Il repo di casa è com’è fatta davvero la mia macchina. Lares è quello che ho imparato facendola girare e che vale la pena tenere anche quando la mia macchina esce dalla storia. Le correzioni viaggiano in entrambe le direzioni, e alcune cose restano private di proposito. Il mio Pi ora accetta solo chiavi SSH, per esempio, ma farne un default di Lares chiuderebbe fuori chiunque abbia seguito la guida di installazione con una password.
Lares fa girare AdGuard Home, Syncthing, Vaultwarden, Uptime Kuma, ntfy, Samba, Tailscale e restic in circa 900 MiB di RAM. Potrei sostituirne metà domani e resterebbe lo stesso progetto, perché il progetto sono in realtà le domande. E se il database sta scrivendo durante il backup? E se un’immagine cambia a monte? E se il backup smette di girare in silenzio? E se tra sei mesi devo ricostruire tutto, dopo essermene dimenticato metà?
Resta parecchio da fare, parcheggiato in issue aperte e non in buoni propositi: le route di Tailscale che vivono ancora in prosa, un output di verifica leggibile da una macchina, e un restore canary che giri da solo, perché un backup che nessuno ha mai ripristinato è ancora soprattutto una promessa.
Quello che sto cercando in tutti i modi di non fare è trasformarlo in una distribuzione da homelab. C’è sempre un altro servizio da installare, e quella strada non finisce mai. Quello che voglio è più piccolo: pochi servizi che contano, su hardware che capisco, con modi di rompersi che ho davvero provocato, e una strada per tornare indietro quando la macchina, prima o poi, morirà.
Ci è voluto un weekend, più un lunedì in cui mi ha morso. Mentre scrivo il Pi è acceso da circa 120 ore, e lo uso tutti i giorni senza pensarci, che era esattamente il punto.
E le ventole della PS5 sono pulite.