Ero lontano da Fantabuddy da dodici giorni. Il listone, nel frattempo, non era andato in vacanza.
Il file con cui avevo lavorato il 5 agosto conteneva 494 righe, di cui 491 attive; quello scaricato il 18 agosto ne conteneva 519, con 504 calciatori attivi. Venticinque nomi nuovi, dodici giocatori usciti dal pool attivo e 148 righe del ranking cambiate. A quattro giorni dall’inizio della Serie A, il mio modello perfettamente riproducibile era già utile soltanto quanto il suo dato più fresco.
Questa è la storia di Fantabuddy. Ma comincia molto prima di Python, DuckDB e dei Brier score.
La prima stagione è sempre con il Milan
Gioco ai manageriali calcistici da Scudetto 03/04, il nome italiano di quello che allora era Championship Manager. Era ancora il grande Milan di Ancelotti, appena tornato da Manchester con la Champions League 2002/03 vinta contro la Juventus. La mia prima carriera in qualunque Scudetto o Football Manager è sempre stata con il Milan. È la squadra che tifo da sempre; non credo che questa tradizione cambierà presto.
Non conoscevo ancora parole come feature engineering o validazione temporale, ma il gioco era già un enorme database attraverso cui prendere decisioni: minuti, forma, ruoli, infortuni, prospettiva e prezzo. Il calcio era la storia; i dati erano il modo per entrarci.
Il passaggio al Fantacalcio è stato naturale. Negli ultimi anni, con più esperienza sui dati, sono arrivate anche diverse vittorie nelle leghe tra amici. Non perché un foglio di calcolo possa prevedere una stagione, ma perché aiuta a fare con più costanza alcune cose poco spettacolari: comprare titolari, distribuire il budget, riconoscere il valore prima che diventi consenso e non innamorarsi di troppe scommesse contemporaneamente.
L’asta quasi perfetta
La stagione 2024/25 è quella che ricordo come la mia asta quasi perfetta. Orsolini e Çalhanoğlu mi hanno portato per gran parte della lega, ma la rosa funzionava perché era costruita bene in ogni reparto.
| Giocatore | Risultato in Serie A 2024/25 |
|---|---|
| Meret | 16 clean sheet, 25 gol subiti, 2 rigori parati |
| Dumfries | 7 gol, 2 assist |
| Çalhanoğlu | 5 gol, 6 assist |
| Orsolini | 15 gol, 4 assist |
| Krstović | 11 gol, 5 assist — comprato a 1 |
I quattro giocatori di movimento produssero insieme 38 gol e 17 assist. Krstović è la fotografia della stagione: un credito, 37 partite a voto, 11 gol e 5 assist. Il colpo che tutti raccontano dopo l’asta, ma che funziona soltanto se intorno non hai costruito una rosa fatta di altri sette colpi da raccontare.
Quell’anno usai anche
fantacalcio-py, il progetto open source di
Antonio Pio Volgarino. Ci ho poi contribuito con quattro pull
request: una CLI, la correzione delle colonne duplicate negli Excel, l’esportazione JSON
e un fix sulla gestione della directory di output. Non era Fantabuddy, ma è stato il
primo ponte concreto tra questa passione e il software open source: uno strumento reale,
usato per un’asta reale, che ho potuto migliorare anche per gli altri.
La stagione successiva ha insegnato la lezione opposta. Nel 2025/26 ho partecipato a due leghe, ho vinto entrambe le coppe e sono arrivato terzo in una delle due, ma il titolo principale è rimasto fuori portata. Vlahović ha subito una lesione di alto grado all’adduttore, Giménez ha dovuto operarsi alla caviglia, De Bruyne ha riportato una lesione di alto grado al bicipite femorale e anche Lukaku si è fermato per un grave problema alla coscia.
Non è un alibi. È la differenza tra la qualità di una decisione e il suo risultato. Puoi costruire bene una rosa e perdere comunque una quantità di minuti che nessun modello pre-asta poteva conoscere.
E poi bisogna gestirla. Nella seconda lega il mio socio Renato è stato fondamentale: schierare la formazione ogni settimana, interpretare il momento, evitare di accumulare scommesse all’asta e correggere gli errori mentre la stagione si muove. Non è su GitHub o LinkedIn, è semplicemente un amico con cui condivido la squadra. I dati preparano il campo; qualcuno deve ancora giocare la partita.
Quello che Fantabuddy controlla davvero
Fantabuddy nasce per rendere ripetibile la parte controllabile. Importa gli snapshot del listone ufficiale, li collega allo storico di API-Football, conserva tutto in DuckDB e produce prezzi coerenti con le regole della mia lega: dieci squadre, venticinque slot a rosa e 10.000 crediti complessivi, riconciliati fino all’ultimo.
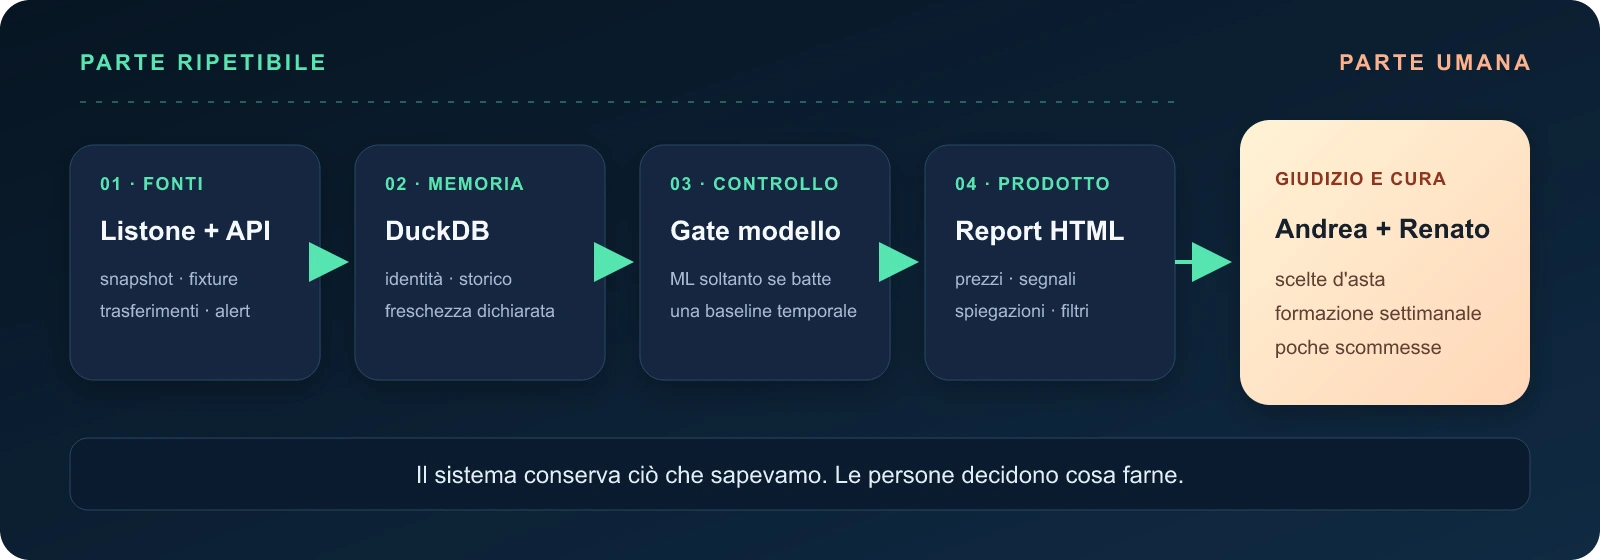
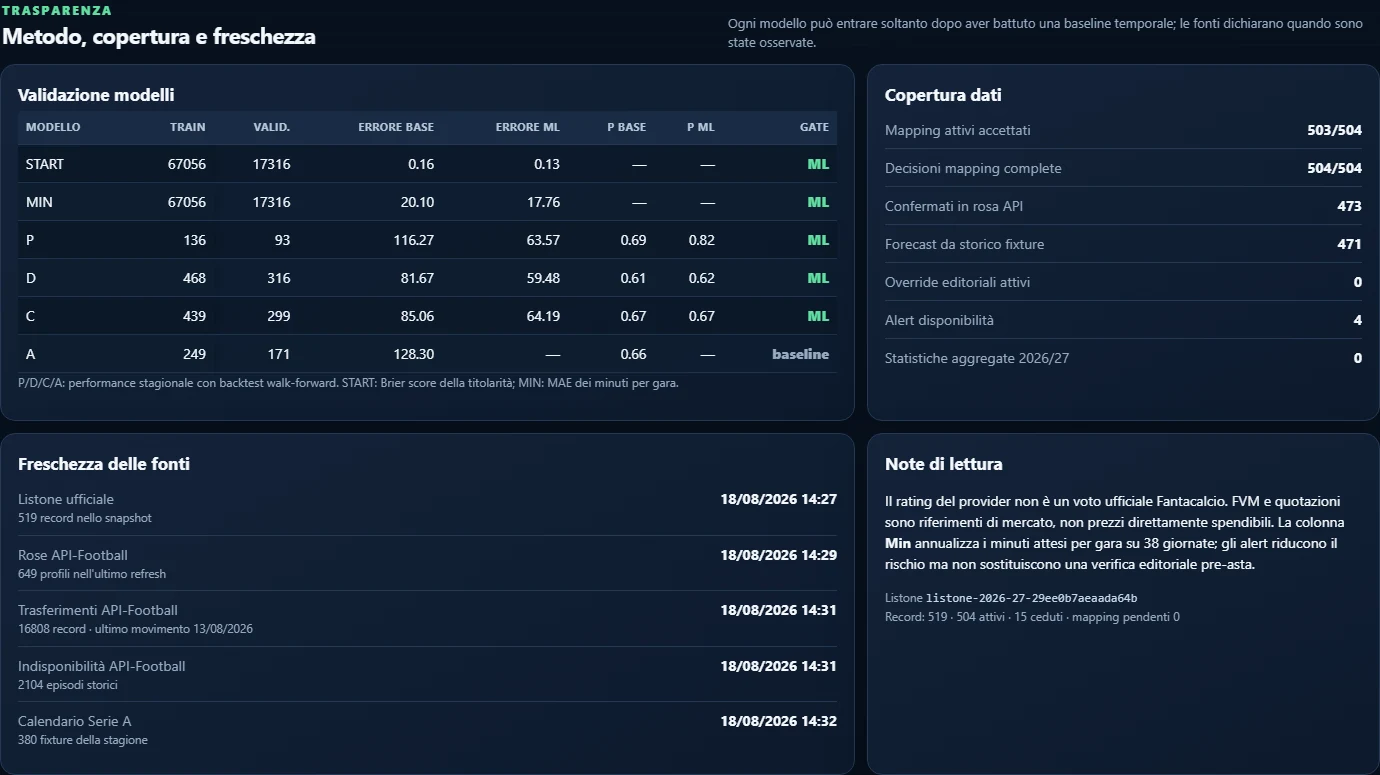
Lo snapshot del 18 agosto contiene 504 calciatori attivi. Per 503 esiste un’identità API accettata; tutti i 504 hanno comunque una decisione esplicita, perché un abbinamento basato sulla sola somiglianza tra stringhe non viene mai approvato in automatico: resta in coda finché non lo guardo io. Per 471 giocatori il sistema può costruire una previsione da storico per fixture. Rose correnti, trasferimenti, indisponibilità e calendario dichiarano tutti quando sono stati osservati.
La granularità per partita conta. Ogni riga usata dal modello vede soltanto ciò che era noto prima di quella gara: le medie mobili terminano alla convocazione precedente e titolarità, minuti, voto e bonus della partita corrente vivono separati come label. Il futuro non può entrare nell’addestramento dalla porta di servizio.
Poi il modello deve guadagnarsi il diritto di comparire nel report, e deve farlo due volte, perché le due cose che stimo vengono controllate in modi diversi.
La disponibilità — partirà titolare, e per quanti minuti — si addestra su tutte le stagioni precedenti l’ultima e si valida sull’ultima, che nel training non entra mai. Quel modello passa soltanto se batte una baseline semplice di almeno l'1%.
| Previsione | Baseline | Modello | Esito |
|---|---|---|---|
| Probabilità di partire titolare, Brier score | 0,1581 | 0,1335 | modello, -15,6% |
| Minuti per partita, MAE | 20,10 | 17,76 | modello, -11,6% |
Sulla performance stagionale la soglia è più alta. Ogni ruolo passa da un backtest walk-forward su più fold, e nel report non entra mai il modello da solo: entra una miscela tra il valore di mercato ufficiale e il modello, pesata al massimo al 60% verso il modello. Per essere accettata, quella miscela deve ridurre l’errore della baseline di almeno il 3% senza perdere correlazione di rango. Portieri, difensori e centrocampisti l’hanno superata. Gli attaccanti no: la loro colonna resta baseline pura.
È il mio risultato preferito dell’intero progetto. Un modello utile non è quello che ha sempre una previsione; è quello autorizzato a perdere quando una risposta più semplice è migliore.
Un prezzo è un’opinione, e la mia sta in un file YAML
Da qualche parte uno score deve diventare un numero da gridare sopra un tavolo, e quel
passaggio non è scienza. È la costituzione della mia lega, scritta in
config/league.default.yaml dove chiunque può non essere d’accordo.
Dieci rose da venticinque slot significano che i giocatori acquistabili sono esattamente 250. Gli altri 254 del listone valgono un credito a testa e finiscono in fascia E: il modello continua a ordinarli, il budget non li vede. Ognuno dei 250 slot riceve un credito come pavimento, e i 9.750 rimanenti si dividono per ruolo — 48% agli attaccanti, 28% ai centrocampisti, 16% ai difensori, 8% ai portieri.
Dentro il ruolo, i soldi non seguono lo score. Seguono la distanza tra il giocatore e l’ultimo che entra ancora in una rosa — il livello di sostituzione — elevata a 1,15, così la curva si sbilancia verso l’alto senza collassarci sopra. Poi un tetto per ruolo: 90, 130, 280, 500. Il 18 agosto il risultato erano 810 crediti ai portieri, 1.640 ai difensori, 2.810 ai centrocampisti e 4.740 agli attaccanti. Esattamente 10.000: se non torna, la build muore su un’assertion.
La parte onesta è quello che fanno i tetti. In tutti e quattro i ruoli c’è esattamente un nome appoggiato al soffitto — Svilar, Dimarco, Nico Paz, Malen. La curva spenderebbe volentieri di più su ciascuno di loro e sono io a non lasciarglielo fare. E quel 48% agli attaccanti non è una scoperta: è una scommessa su come si comporta la mia lega all’asta, un numero in un file, e posso sbagliarlo per un’intera stagione.
Anche le API possono non sapere
Avere migliaia di chiamate disponibili non è un motivo per consumarle. Prima dell’inizio del campionato, API-Football dichiarava ancora non disponibili le statistiche giocatore e gli infortuni della Serie A 2026/27. Ho aggiornato ciò che poteva davvero essere cambiato — rose, trasferimenti, storico delle indisponibilità e calendario — e ho lasciato il resto fermo. Il provider stesso raccomanda di controllare la copertura prima di ogni acquisizione.
La copertura, inoltre, non equivale alla completezza. Ricostruendo la stagione 2025/26, lo storico che ho acquisito conteneva correttamente il problema alla coscia di Lukaku, ma per De Bruyne nessun episodio, per Vlahović nemmeno il giocatore — nel frattempo era uscito dal pool su cui interrogo le rose — e per Giménez una distorsione estiva alla caviglia al posto dell’operazione di dicembre che ho vissuto per davvero. Tre giocatori, tre modi diversi in cui il dato può mancare. Per questo nel report gli infortuni sono alert da verificare, non cartelle cliniche. L’API riduce l’incertezza; non la cancella.
Anche i rating sotto tutto il modello sono quelli del provider, non i voti ufficiali del Fantacalcio. Tutto ciò che Fantabuddy stima è un proxy di quello che la mia lega assegna davvero. Preferisco scriverlo qui piuttosto che lasciarlo scoprire a qualcuno nella quarta colonna del ranking.
Il prodotto è l’HTML
Un Parquet non mi accompagna all’asta. Un notebook aperto a metà non mi dice rapidamente quali titolari probabili costano quaranta crediti o meno. Per questo l’output principale di Fantabuddy è un report HTML autonomo, filtrabile e utilizzabile offline.
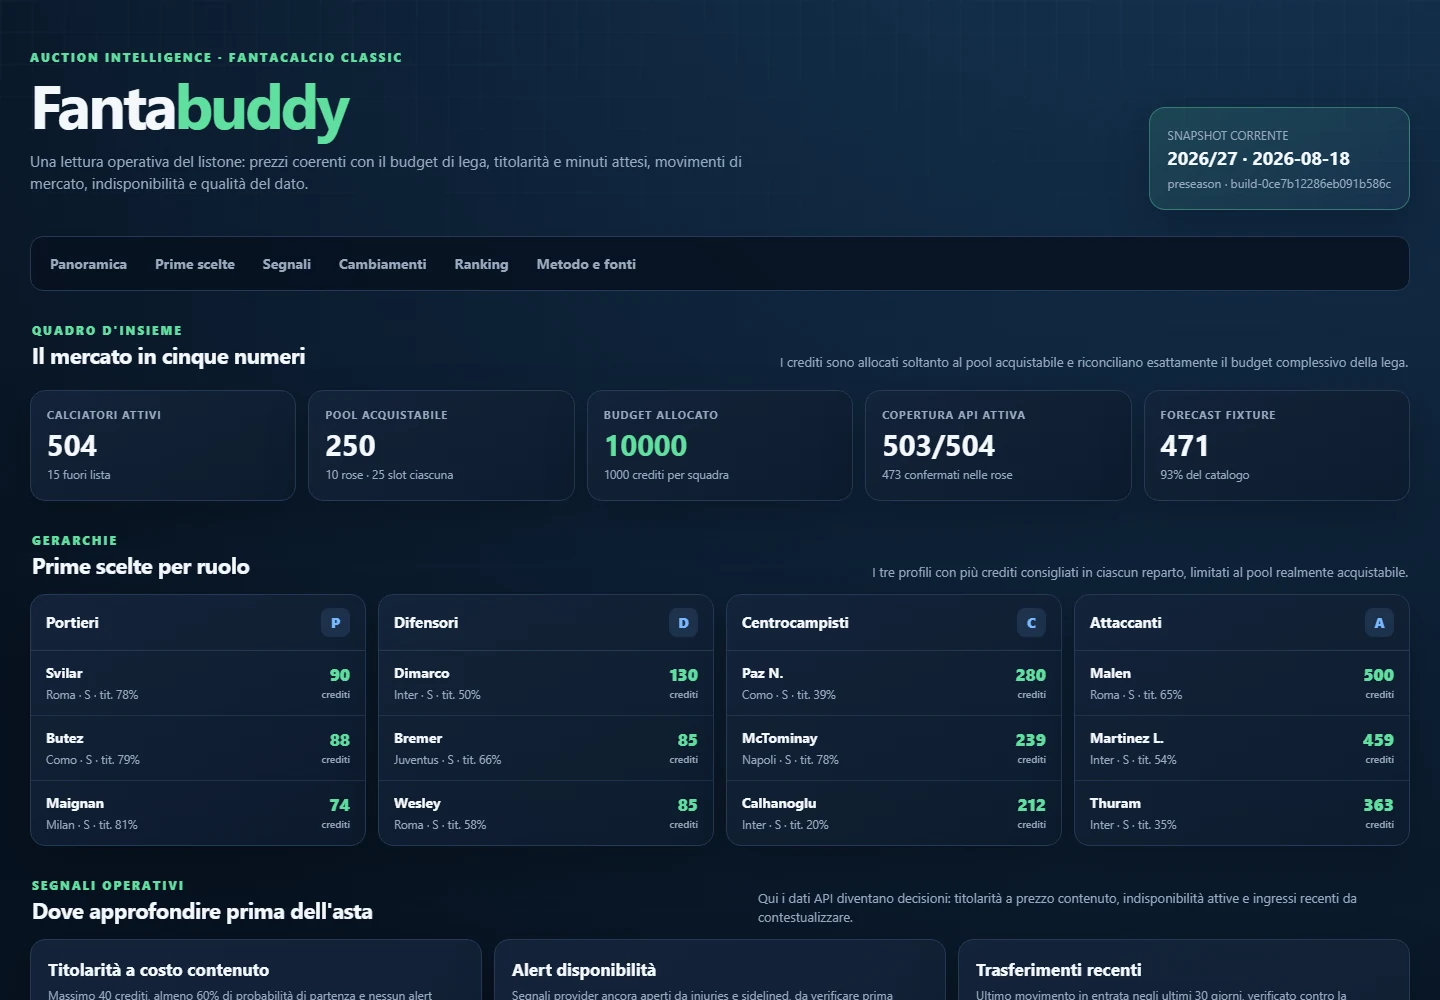
Mostra le prime scelte per ruolo, i possibili titolari a basso costo, gli alert di disponibilità, i trasferimenti recenti e le differenze rispetto allo snapshot precedente. Il ranking completo espone prezzo, FVM, titolarità, minuti attesi, bonus, affidabilità e la spiegazione della stima. In fondo, invece di nasconderli, mette i gate dei modelli, la copertura e la freschezza di ogni fonte.
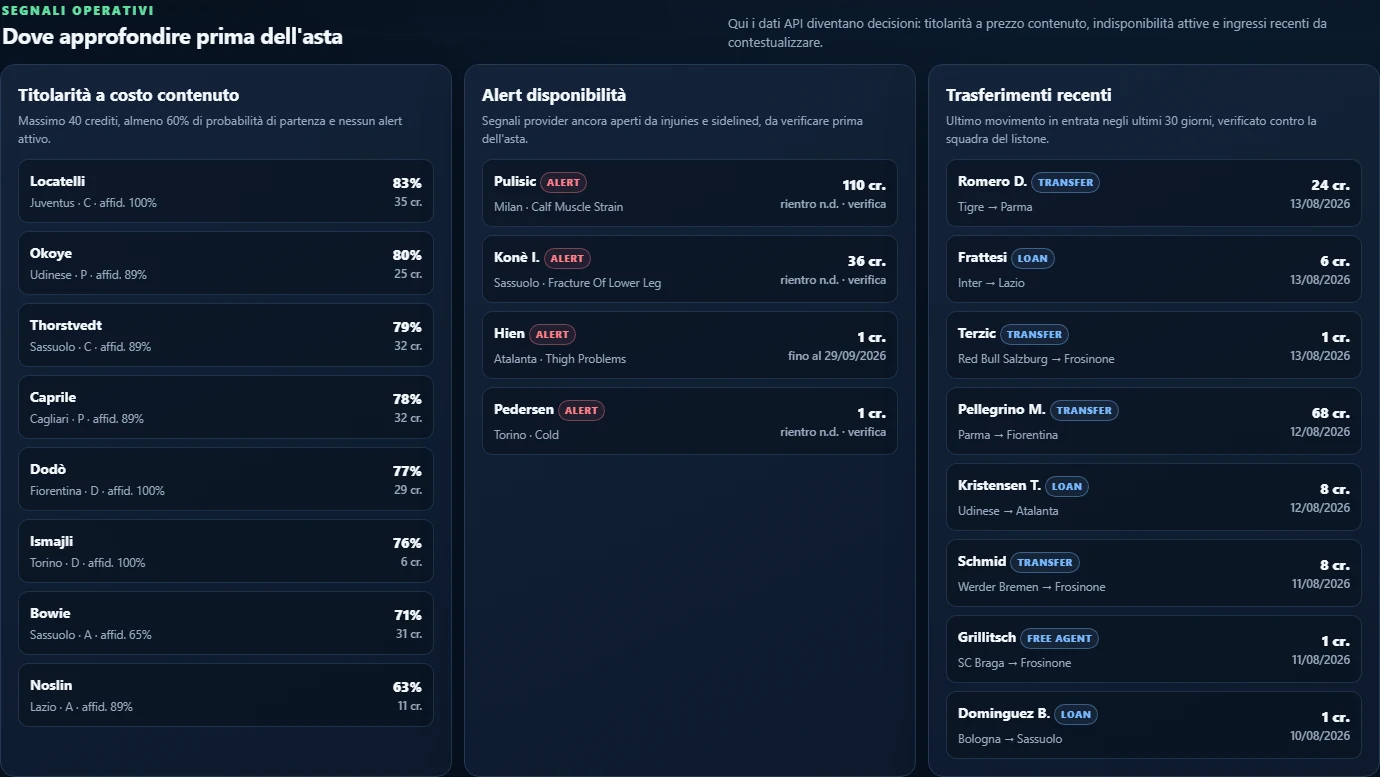
Non mi dirà chi comprare senza pensare. Non impedirà a quattro attaccanti di farsi male e non schiererà la formazione con Renato. Fa qualcosa di meno spettacolare e più utile: conserva ciò che sapevamo, quando lo sapevamo, e perché una decisione sembrava buona.
In Scudetto 03/04 il database era il mondo in cui immaginavo la mia prossima stagione con il Milan. Vent’anni dopo ne ho costruito uno molto più piccolo per preparare un’asta tra amici. La passione è la stessa. Adesso ha snapshot immutabili e un report HTML.
Dove si trova il lavoro
Fantabuddy è disponibile su
AndreaBozzo/fantabuddy. Il progetto che ho
usato nella stagione 2024/25 è
piopy/fantacalcio-py; le mie quattro
contribuzioni sono raccolte nella
ricerca delle pull request.
Le statistiche 2024/25 citate sopra sono verificabili negli archivi Fantacalcio di Orsolini, Çalhanoğlu, Dumfries, Krstović e Meret. I comunicati dei club documentano gli infortuni di Lukaku, De Bruyne, Vlahović e Giménez.
Grazie ad Antonio per aver messo fantacalcio-py in open source, e a Renato per tutto
quello che accade dopo che il report è stato chiuso e la giornata deve ancora essere
schierata.